Elorian, een AI-start-up uit Palo Alto, heeft vrijdag zijn eerste model uitgebracht. Het heet Glimpse en is gebouwd om beter te kunnen kijken. Dat meldt TechCrunch, dat het nieuws als eerste kreeg. Voorlopig is Glimpse een onderzoeksversie, die je via een API en via een chatomgeving kunt gebruiken.
Niet één keer kijken, maar steeds terug naar het beeld
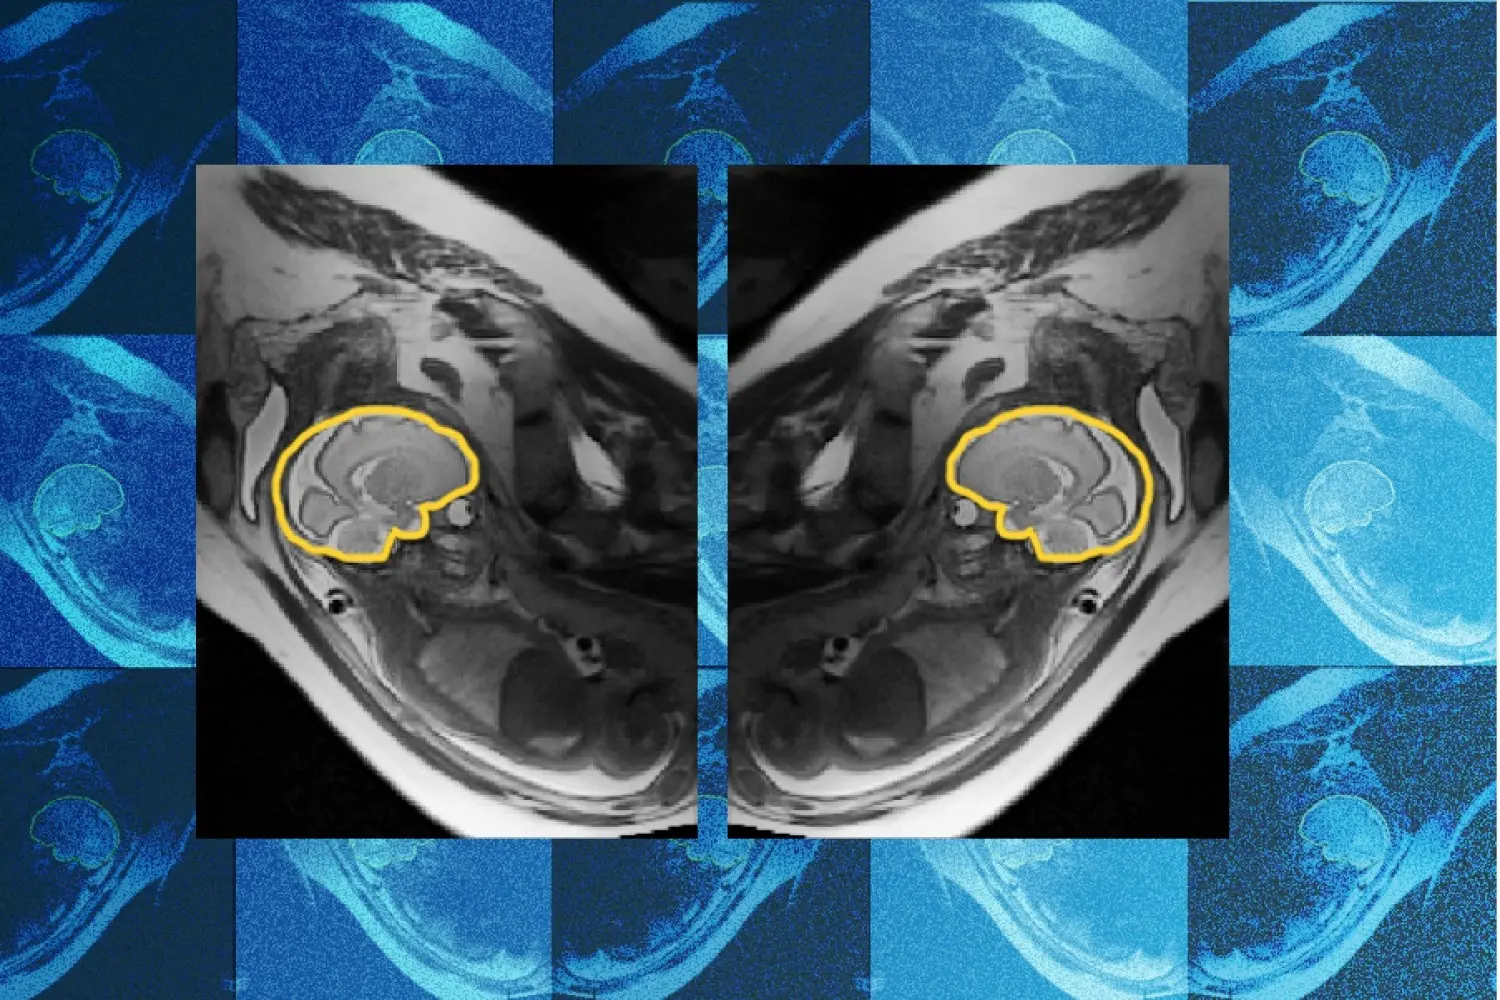
De meeste AI-modellen die beeld begrijpen, bekijken een foto één keer. Ze zetten die om in een reeks tokens en redeneren daarna verder in tekst. Volgens Elorian is dat te vergelijken met een foto beschrijven uit je geheugen. Glimpse werkt anders: tijdens het redeneren kan het model terugkeren naar het origineel. Het kan inzoomen op een stukje van de afbeelding, losse beelden uit een video halen of code draaien om iets te meten of te vergelijken. Elorian noemt dat een "visuele kladruimte".
Helemaal nieuw is het idee niet. OpenAI gaf zijn redeneermodellen in 2025 al de mogelijkheid om tijdens het nadenken in te zoomen. Het verschil is volgens Elorian dat het hele model om deze aanpak heen is gebouwd, en dat dat goedkoop kon. Een klein team trainde Glimpse op een paar honderd GPU's, en het model is volgens het bedrijf flink kleiner dan de topmodellen waarmee het zich vergelijkt.
Wat het kost en hoe goed het is
Gebruik van Glimpse kost 0,60 dollar per miljoen tokens invoer en 3 dollar per miljoen tokens uitvoer. Daarmee is het goedkoper dan middenklassemodellen, maar duurder dan de lichtste modellen van grote aanbieders.
Over de prestaties is alleen bekend wat Elorian zelf heeft gemeten. Volgens het bedrijf scoort Glimpse beter dan GPT-6 Astra van OpenAI bij het interpreteren van wetenschappelijke grafieken en het beschrijven van korte video's. Op andere taken voor visueel redeneren zou het model in de buurt komen van de concurrentie. Onafhankelijke tests zijn er nog niet.
Van een bordspel tot robots
Topman Andrew Dai, eerder onderzoeker bij Google DeepMind, kwam op het idee na een spelletjesavond. Hij fotografeerde een afgelopen bordspel en vroeg een topmodel wie er won. Het model kon het niet zeggen. Mensen begrijpen symbolen en plaatjes zonder tekst vaak meteen, zei Dai tegen TechCrunch, en kunnen zelfs een Ikea-kast in elkaar zetten met alleen tekeningen. AI-modellen kunnen dat nog niet.
Elorian richt zich eerst op bedrijven met veel videomateriaal, zoals robotbouwers, wetenschappelijke labs en mediabedrijven. Op langere termijn wil het bedrijf dat zijn modellen niet alleen zien, maar ook handelen, bijvoorbeeld door robots aan te sturen. Volgend jaar wil Elorian het beste model voor visueel redeneren op de markt hebben.
De start-up kwam een half jaar geleden naar buiten met een startinvestering van 55 miljoen dollar, bij een waardering van 300 miljoen dollar. Die ronde werd geleid door Striker Venture Partners, Menlo Ventures en Altimeter Capital. Ook Nvidia en Google-hoofdwetenschapper Jeff Dean investeerden.
Wat betekent dit voor jou?
Voorlopig weinig direct: Glimpse is een onderzoeksversie, en of het in Nederland beschikbaar is, meldt Elorian niet. Het model laat wel zien waar AI op beeldgebied naartoe gaat. Wie AI vraagt om een grafiek, schema of video te lezen, merkt nu vaak dat modellen details missen. Modellen die zelf kunnen inzoomen en nameten, moeten dat soort fouten verminderen.
Bijgewerkt op 17 oktober: de bron meldt inmiddels dat de chatomgeving direct beschikbaar is, in plaats van via een wachtlijst. Ook is Striker Venture Partners toegevoegd als een van de leidende investeerders.