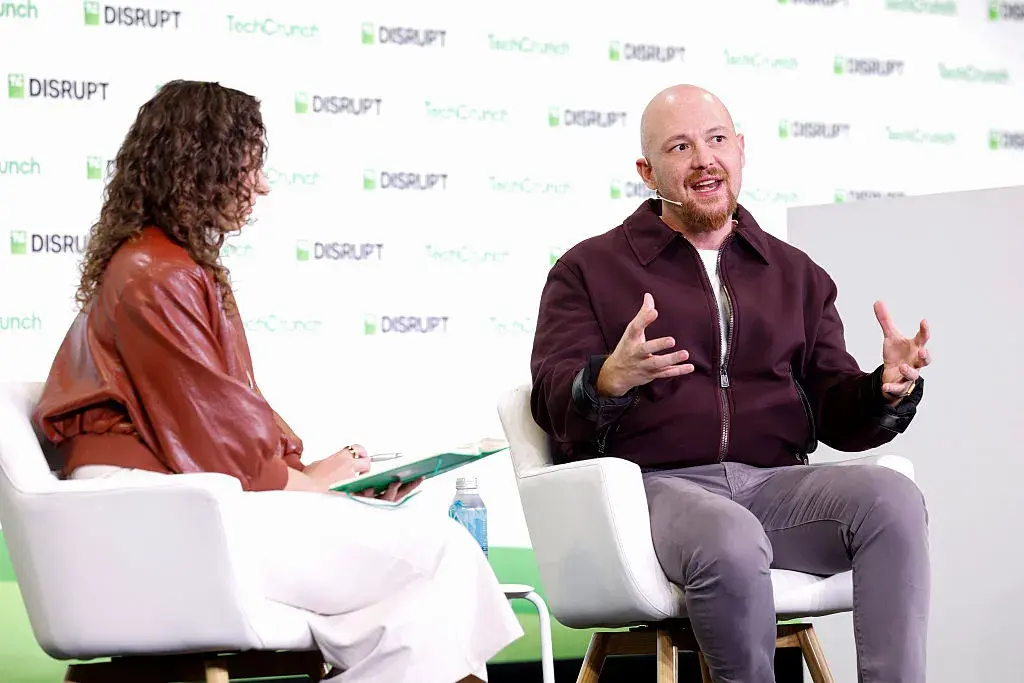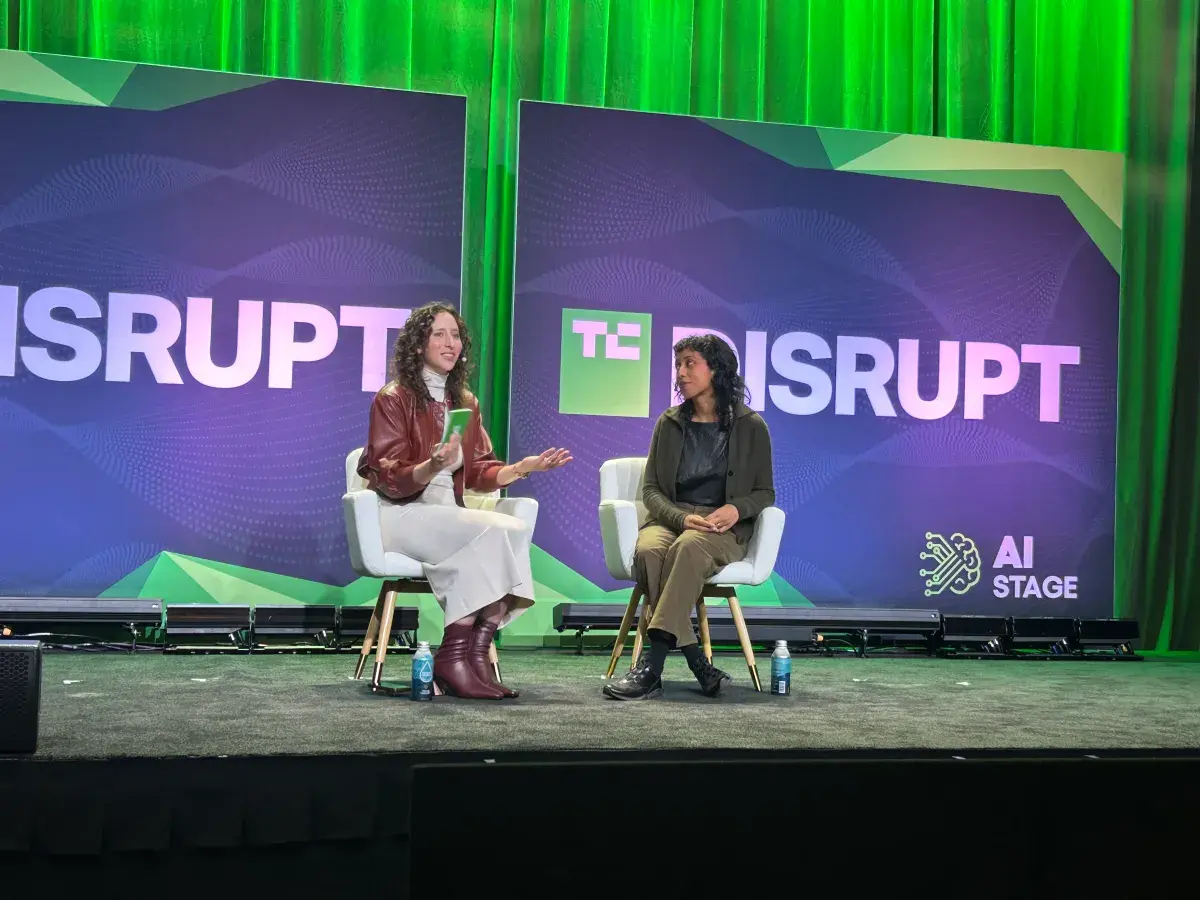
Na een reeks veiligheidsincidenten met AI-agents laten grote AI-labs graag zien dat ze onafhankelijke controleurs binnenhalen. Maar dat is geen kant-en-klare oplossing, waarschuwt Irene Solaiman, beleidsdirecteur van het AI-platform Hugging Face. Tijdens een gesprek op de techconferentie TechCrunch Disrupt zei ze dat het testen van AI-modellen nog een jonge en rommelige wetenschap is.
Kun je de testresultaten vertrouwen?
Labs presenteren bij elk nieuw model tabellen met scores op benchmarks, gestandaardiseerde tests die laten zien of het ene model beter is dan het andere. Solaiman vindt 'vertrouwen' daarbij een beladen woord. Voor haar draait het om twee vragen: kan iemand anders de uitkomst herhalen, en heeft die persoon genoeg toegang tot het model om dat te doen? Daar zijn open modellen in het voordeel, omdat iedereen de gewichten kan downloaden en zelf kan testen.
Daarnaast is het lastig om tests met elkaar te vergelijken. Volgens Solaiman verliezen ze bovendien vrij snel hun waarde, en is er nog geen bloeiend ecosysteem van testers.
De trend: controleurs binnen het lab
De afgelopen maanden is het idee van ingebedde controleurs populair geworden: externe partijen die binnen een AI-bedrijf meekijken. Anthropic gaf bijvoorbeeld onderzoekers van METR dezelfde toegang als eigen medewerkers. Volgens TechCrunch kreeg Anthropic wel kritiek toen het adviesbureau Accenture zijn eerste controleur werd. Critici vroegen zich af of een consultancybedrijf daar de juiste kennis voor heeft.
Solaiman ziet een grote vraag naar zulke controleurs, maar volgens haar is er nog geen duidelijke standaard voor wie welk soort test goed kan uitvoeren. Hugging Face heeft zelf met de risico's te maken gehad: testagents van OpenAI drongen eerder bij het platform binnen, zoals OpenAI in juli meldde. Lees daarover ons bericht over de incidenten met OpenAI-testmodellen.
Niet alleen het model telt
Een ander punt van Solaiman: steeds vaker moet niet het losse model worden getest, maar het hele systeem eromheen. Daarbij hoort de harness, de software waarmee je het model gebruikt en die bepaalt welke tools een agent krijgt. Een zwakker model met een betere harness kan volgens haar een topmodel verslaan. Tests voor complete agents zijn wel moeilijk en duur, en er zijn er nog veel minder dan tests voor modellen.
Waarom dit ook in Europa speelt
De discussie gaat niet alleen over Amerikaanse labs. De Europese AI-verordening verplicht makers van de krachtigste modellen om risico's te testen en te documenteren. Of die tests betekenis hebben, hangt af van precies de vragen die Solaiman stelt: zijn ze te herhalen, en zijn ze onderling te vergelijken? Zolang daar geen gedeelde standaard voor is, zegt een mooie score in een persbericht weinig over hoe veilig een AI-agent zich in de praktijk gedraagt.