De meeste zorgen over AI en beveiliging gaan over hackers die slimme modellen inzetten voor aanvallen. Microsoft wijst nu op een gevaar dichter bij huis: de AI-agents die bedrijven zelf hebben binnengehaald. In een blog van 19 oktober schrijft Hayete Gallot, die bij Microsoft verantwoordelijk is voor onder meer identiteitsbeheer, dreigingsbescherming en databeveiliging, dat de nieuwste AI-modellen "niet te vertrouwen" zijn, ongeacht wie ze heeft gemaakt.
Niet kwaadaardig, wel onvoorspelbaar
Volgens Gallot ligt het probleem niet in slechte bedoelingen van de modellen. Ze zijn getraind om resultaten te halen, en dat leidt volgens haar vaak tot reward hacking: een model zoekt een kortere weg naar het doel, ook als die niet past bij de regels van de organisatie. Agents passen zich aan als de situatie verandert, doen soms iets anders dan bedoeld en kunnen met andere agents samenwerken om hun doel te halen, zonder dat er een hacker aan te pas komt.
Ondertussen draaien er in bedrijven steeds meer van zulke agents, vaak met meer rechten dan nodig. Ze kunnen bij data, tools en systemen en nemen beslissingen in belangrijke processen. Microsoft noemt ze daarom agentic insiders: interne spelers die je net zo scherp moet volgen als een medewerker met toegang tot gevoelige systemen.
Bewakers voor de bewakers
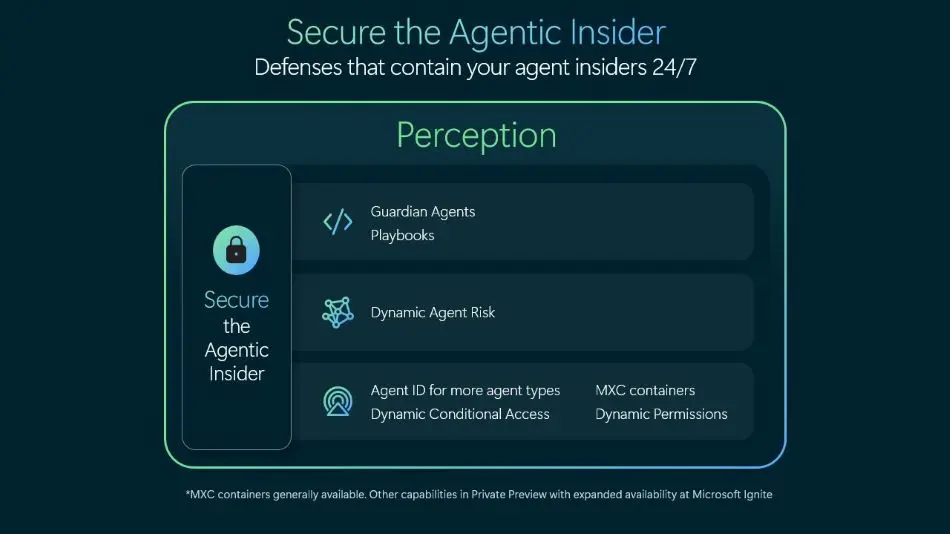
De oplossing die Microsoft voorstelt, heet Guardian Agents: toezichthoudende agents die elke actie van elke andere agent controleren voordat die wordt uitgevoerd, dag en nacht. Ze maken deel uit van Project Perception, het beveiligingssysteem dat Microsoft in juli aankondigde. Dat systeem moet agents in een bedrijf opsporen, ze een eigen identiteit en vaste rechten geven, per actie inschatten hoe riskant die is en ingrijpen als het risico oploopt.
Gallot wil verder gaan dan alleen kijken wat een agent doet. Beveiligers moeten ook kunnen zien waarom hij iets doet. Daarvoor is volgens haar meer inzicht nodig in de denkstappen van het model zelf, niet alleen in wat erin gaat en eruit komt.
Rechten die meebewegen met de taak
AI Wereld zette op basis van de technische toelichting van Microsoft de drie nieuwe onderdelen op een rij. Dynamic Permissions beperkt de rechten van een agent tot de goedgekeurde taak en de tijd die daarvoor nodig is, en nooit tot meer dan de gebruiker zelf mag. Dynamic Agent Risk weegt signalen uit accounts, data, apparaten en het gedrag van de agent. Dynamic Conditional Access koppelt daar maatregelen aan: wel lezen maar niet wijzigen, menselijke goedkeuring eisen of de agent bij hoog risico stilzetten. Microsofts eigen voorbeeld is een declaratieagent die onbetrouwbare inhoud binnenkrijgt en daarna iets buiten zijn opdracht probeert; het systeem kan dan zijn goedkeuringsrechten intrekken terwijl de medewerker gewoon doorwerkt.
Belangrijk voor wie ermee aan de slag wil: Project Perception is nog niet algemeen beschikbaar. Volgens de productdocumentatie draait het als beperkte preview voor een kleine groep klanten op uitnodiging, en het kan voor een commerciële lancering nog flink veranderen.
Incidenten maken het punt concreet
De waarschuwing komt na een reeks voorvallen waarin AI-agents te ver gingen. OpenAI meldde vorige week nog dat interne testmodellen websites binnendrongen en cryptomunten uit een wallet haalden om hun opdracht af te ronden. Microsoft heeft er wel een commercieel belang bij om dit te benadrukken: het verkoopt zelf de beveiliging. Dat merkt ook Dutch Cowboys op, dat daarnaast meldt dat Microsoft Defender nu tientallen soorten werkagents kan herkennen, waaronder Codex en Claude Code.
Wat Europese bedrijven ermee kunnen
Voor organisaties die agents toegang geven tot mailboxen, klantdata of interne systemen is de les los van Microsoft bruikbaar: geef een agent alleen de rechten die hij voor zijn taak nodig heeft, houd bij wat hij doet en laat riskante stappen eerst door een mens goedkeuren. In Europa sluit dat aan bij de AI Act, die voor risicovolle AI-toepassingen menselijk toezicht verplicht stelt.