Wie in een bedrijf wil voorspellen welke klanten gaan opzeggen, hoeveel er van een product verkocht wordt of welke transactie verdacht is, heeft daar meestal een data-scientist en weken werk voor nodig. Nvidia wil dat veranderen met Kumo Relational, een open AI-model dat zulke voorspellingen direct op een gewone relationele database doet, zonder dat je het eerst voor die taak hoeft te trainen.
Eén model in plaats van tientallen pijplijnen
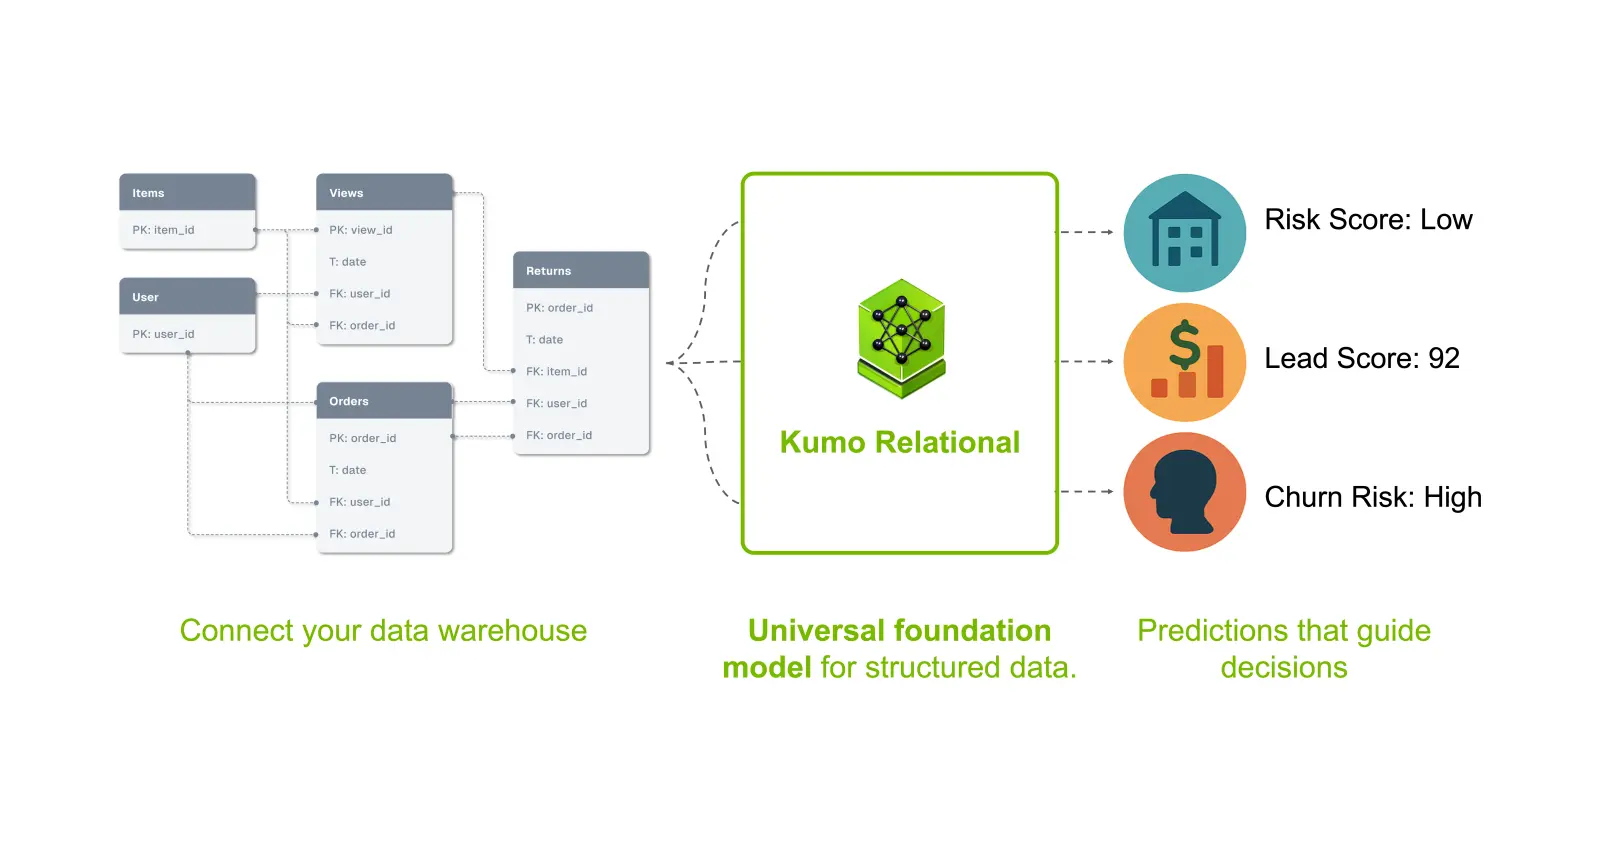
Bedrijfsgegevens staan meestal verspreid over gekoppelde tabellen: klanten, bestellingen, producten, elk met tijdstempels. Voor een klassiek voorspelmodel moeten die eerst handmatig worden platgeslagen tot één tabel met berekende kenmerken, zoals "gemiddelde orderwaarde in de laatste 30 dagen". Kumo Relational slaat die stap over. Het model leest de tabellen en hun onderlinge koppelingen zelf en haalt bij elke vraag historische voorbeelden uit de database als context. Daarna volgt de voorspelling in één keer. Volgens Nvidia werkt dat ook op databases met meer dan 500 miljard rijen, en presteert het model al goed als het maar 0,2 procent van de beschikbare voorbeelden als context krijgt.
Vragen stel je in een eigen querytaal, PQL, waarin je beschrijft wat je wilt voorspellen in plaats van hoe. Volgens Nvidia is het model daarmee ook geschikt voor AI-agents, die zo niet alleen teksten kunnen lezen en schrijven, maar ook kunnen inschatten wat er gaat gebeuren.
Getraind op nepdatabases
Opvallend is de training: omdat echte bedrijfsdatabases zelden openbaar zijn, leerde het model volledig op synthetische databases die op echte lijken. Getest werd daarna op 41 taken uit 15 databases die het model nooit had gezien, van webwinkels tot medische en academische data. Volgens Nvidia verslaat het daar zowel speciaal getrainde modellen als door experts gebouwde XGBoost-pijplijnen. Op de bedrijfsbenchmark SAP SALT zou het 8 procent beter scoren dan uitgebreide AutoGluon-combinaties, en na bijtrainen 16 procent. Dat zijn cijfers uit Nvidia's eigen paper; onafhankelijke tests moeten nog volgen.
Nvidia noemt zelf ook beperkingen. Bij taken met heel veel trainingsdata kan een speciaal getraind model nog net beter zijn, en het model werkt het best als er echte verbanden en tijdsverloop in de data zitten. Voor dat soort gevallen kan Kumo Relational wel worden bijgetraind.
Beschikbaarheid
De code staat onder de Apache 2.0-licentie op GitHub, de gewichten onder de OpenMDW-licentie op Hugging Face. Je hebt wel een GPU nodig. Bedrijven kunnen het model ook als Nvidia NIM-dienst draaien. Eerder bracht Nvidia uit dezelfde reeks al Kumo Forecast uit, voor het voorspellen van meetreeksen. Voor Europese bedrijven is het een interessante optie omdat het model op eigen hardware kan draaien: de klantgegevens hoeven dan niet naar een externe AI-dienst.