Wie een open model als Qwen of Gemma bijtraint voor één specifieke taak, neemt ongemerkt iets mee wat daar slecht bij past: het woordenboek van dat model. Het AI-bedrijf Dharma AI laat in een blog op Hugging Face zien hoeveel dat kan kosten, en wat er gebeurt als je dat woordenboek op maat maakt.
Waarom het woordenboek geld kost
Een taalmodel leest en schrijft niet in woorden, maar in tokens: stukjes tekst. Welke stukjes dat zijn, bepaalt de tokenizer. Bij grote algemene modellen is die gebouwd voor alles tegelijk, van programmeercode tot Chinees. Voor een model dat maar één klus doet, levert dat volgens Dharma AI twee soorten verspilling op.
- Tekst die in de taak steeds terugkomt, wordt in veel kleine stukjes gehakt. Elk stukje kost rekenwerk.
- Het model berekent bij elk nieuw token de kans voor alle ruim 150.000 woorddelen in het woordenboek, ook voor duizenden die de taak nooit gebruikt.
Daar komt bij dat schrijven duurder is dan lezen. Bij het nakijkmodel dat Dharma AI onderzocht, kostte een gegenereerd token 7,4 keer zoveel als een gelezen token. Die verhouding hangt wel af van de hardware en de belasting.
Het experiment: een nakijkmodel voor Portugese opstellen
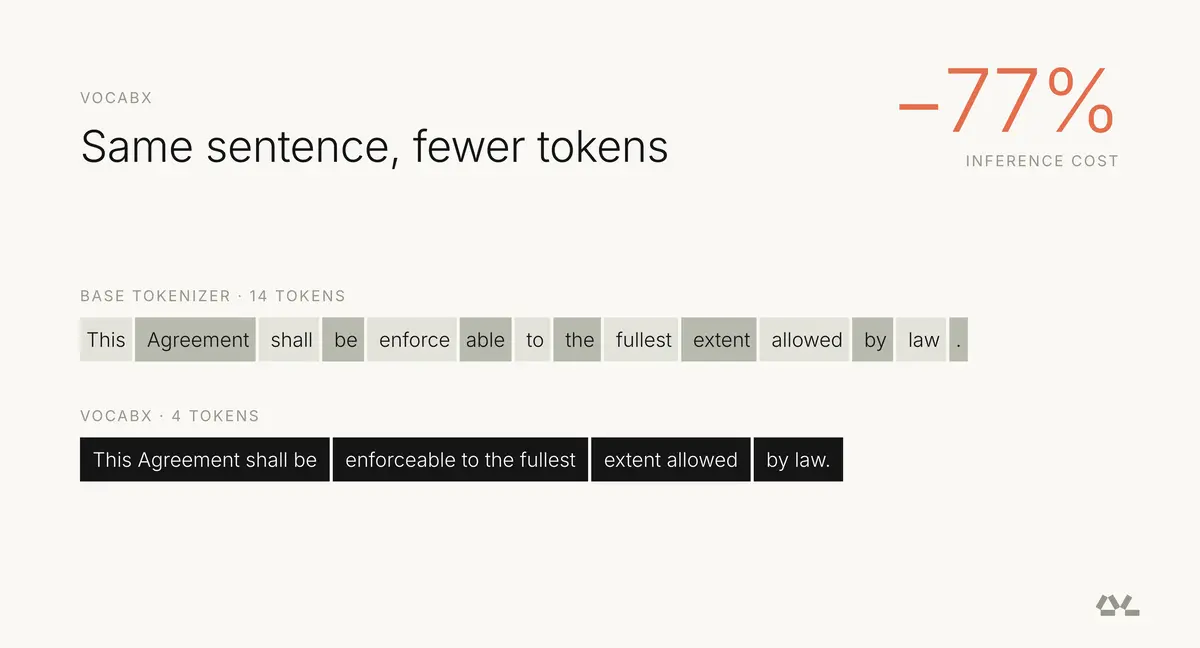
Dharma AI draait een systeem dat Portugese opstellen beoordeelt, gebouwd op het kleine model Qwen3-4B. Het geeft per onderdeel een cijfer en een opmerking terug in een vast formaat. Met een eigen methode, VocabX, bouwde het bedrijf een nieuw woordenboek. Dat kiest woorddelen niet op hoe vaak ze voorkomen, maar op hoeveel ze besparen, en voegt ook vaste zinsdelen en complete opmaakblokken samen tot één token. Het woordenboek kromp van ongeveer 152.000 naar 65.000 woorddelen.
De uitkomst volgens het bedrijf: een antwoord telde gemiddeld 101 in plaats van 350 tokens, de gemeten kosten daalden met 77 procent en de kwaliteitsscore steeg van 0,703 naar 0,810. Basismodel, trainingsdata en trainingsmethode bleven gelijk.
Er ging ook iets mis. Een eerste versie die het cijfer samen met de omringende opmaak in één token stopte, was nog compacter maar scoorde slechter dan het oude model. Pas toen het cijfer een eigen token kreeg, ging de kwaliteit omhoog. De les die Dharma AI trekt: comprimeer niet het stukje waar het model juist over moet beslissen.
Kanttekeningen
Alle cijfers komen van Dharma AI zelf. Het bijbehorende onderzoeksartikel wordt nog beoordeeld en is niet gepubliceerd, dus de getallen kunnen nog veranderen. Wel vergeleek het bedrijf zijn methode met drie bestaande technieken op vijf openbare tekstsoorten en drie modelfamilies, en kwam het daar volgens eigen meting steeds beter uit.
Relevant voor Nederlandstalige toepassingen
Het onderzoek gaat over Portugees, maar het onderliggende idee geldt voor elke taal en elke vaste taak. Een algemeen woordenboek moet veel talen en tekstsoorten tegelijk bedienen en is daardoor zelden zuinig voor één specifieke toepassing. Voor bedrijven en overheden die een klein open model zelf draaien voor één vaste klus, zoals het samenvatten van dossiers of het controleren van formulieren, is het woordenboek daarmee een kostenpost die je zelden ziet maar wel kunt aanpakken. Het vraagt wel dat je het model opnieuw traint met het nieuwe woordenboek.