Liquid AI heeft LFM3 uitgebracht, de derde generatie van zijn kleine taalmodellen. In plaats van één groot model dat alles kan, levert het bedrijf zes modellen van ongeveer 2 miljard parameters die allemaal op dezelfde basis zijn gebouwd. Je kiest het model dat bij je invoer past (tekst, beeld, geluid of alles tegelijk) en past het daarna aan voor je eigen taak. Alle modellen zijn open: je kunt ze gratis downloaden via Hugging Face.
Wat zit er in de familie?
- LFM3-1.7B: het tekstmodel, bedoeld voor lokale AI-agents die tools aanroepen. Op 4-bit precisie past het in ongeveer 1 GB geheugen en het kan 256.000 tokens context aan.
- LFM3-VL-2B: begrijpt beelden en, voor het eerst bij Liquid, ook video.
- LFM3-Audio-2B: voor spraakherkenning, spraak maken en vertalen in 18 talen.
- LFM3-Omni-2B: het eerste model van Liquid dat tegelijk kijkt, luistert en terugpraat.
- d1-2B en d1-omni-2B: zogeheten beslismodellen die geen tekst schrijven, maar per vraag een kans teruggeven, bijvoorbeeld om tickets of facturen te sorteren.
Liquid zegt niet of Nederlands bij de 18 talen van het audiomodel hoort. Wie het voor Nederlandse spraak wil gebruiken, moet dat dus zelf testen.
Kleiner en toch sterker, volgens Liquid
De claims zijn fors, en komen allemaal van Liquid zelf. Het nieuwe tekstmodel zou zijn voorganger LFM2.5-2.6B verslaan met 35 procent minder parameters. Op de agenttest WebArena-Verified scoort het volgens Liquid 38,42 tegen 3,02 voor de oude versie. Het beeldmodel zou over 62 tests gemiddeld even goed scoren als Gemma 4 12B, een model dat ruim zes keer zo groot is. Onafhankelijke metingen zijn er nog niet.
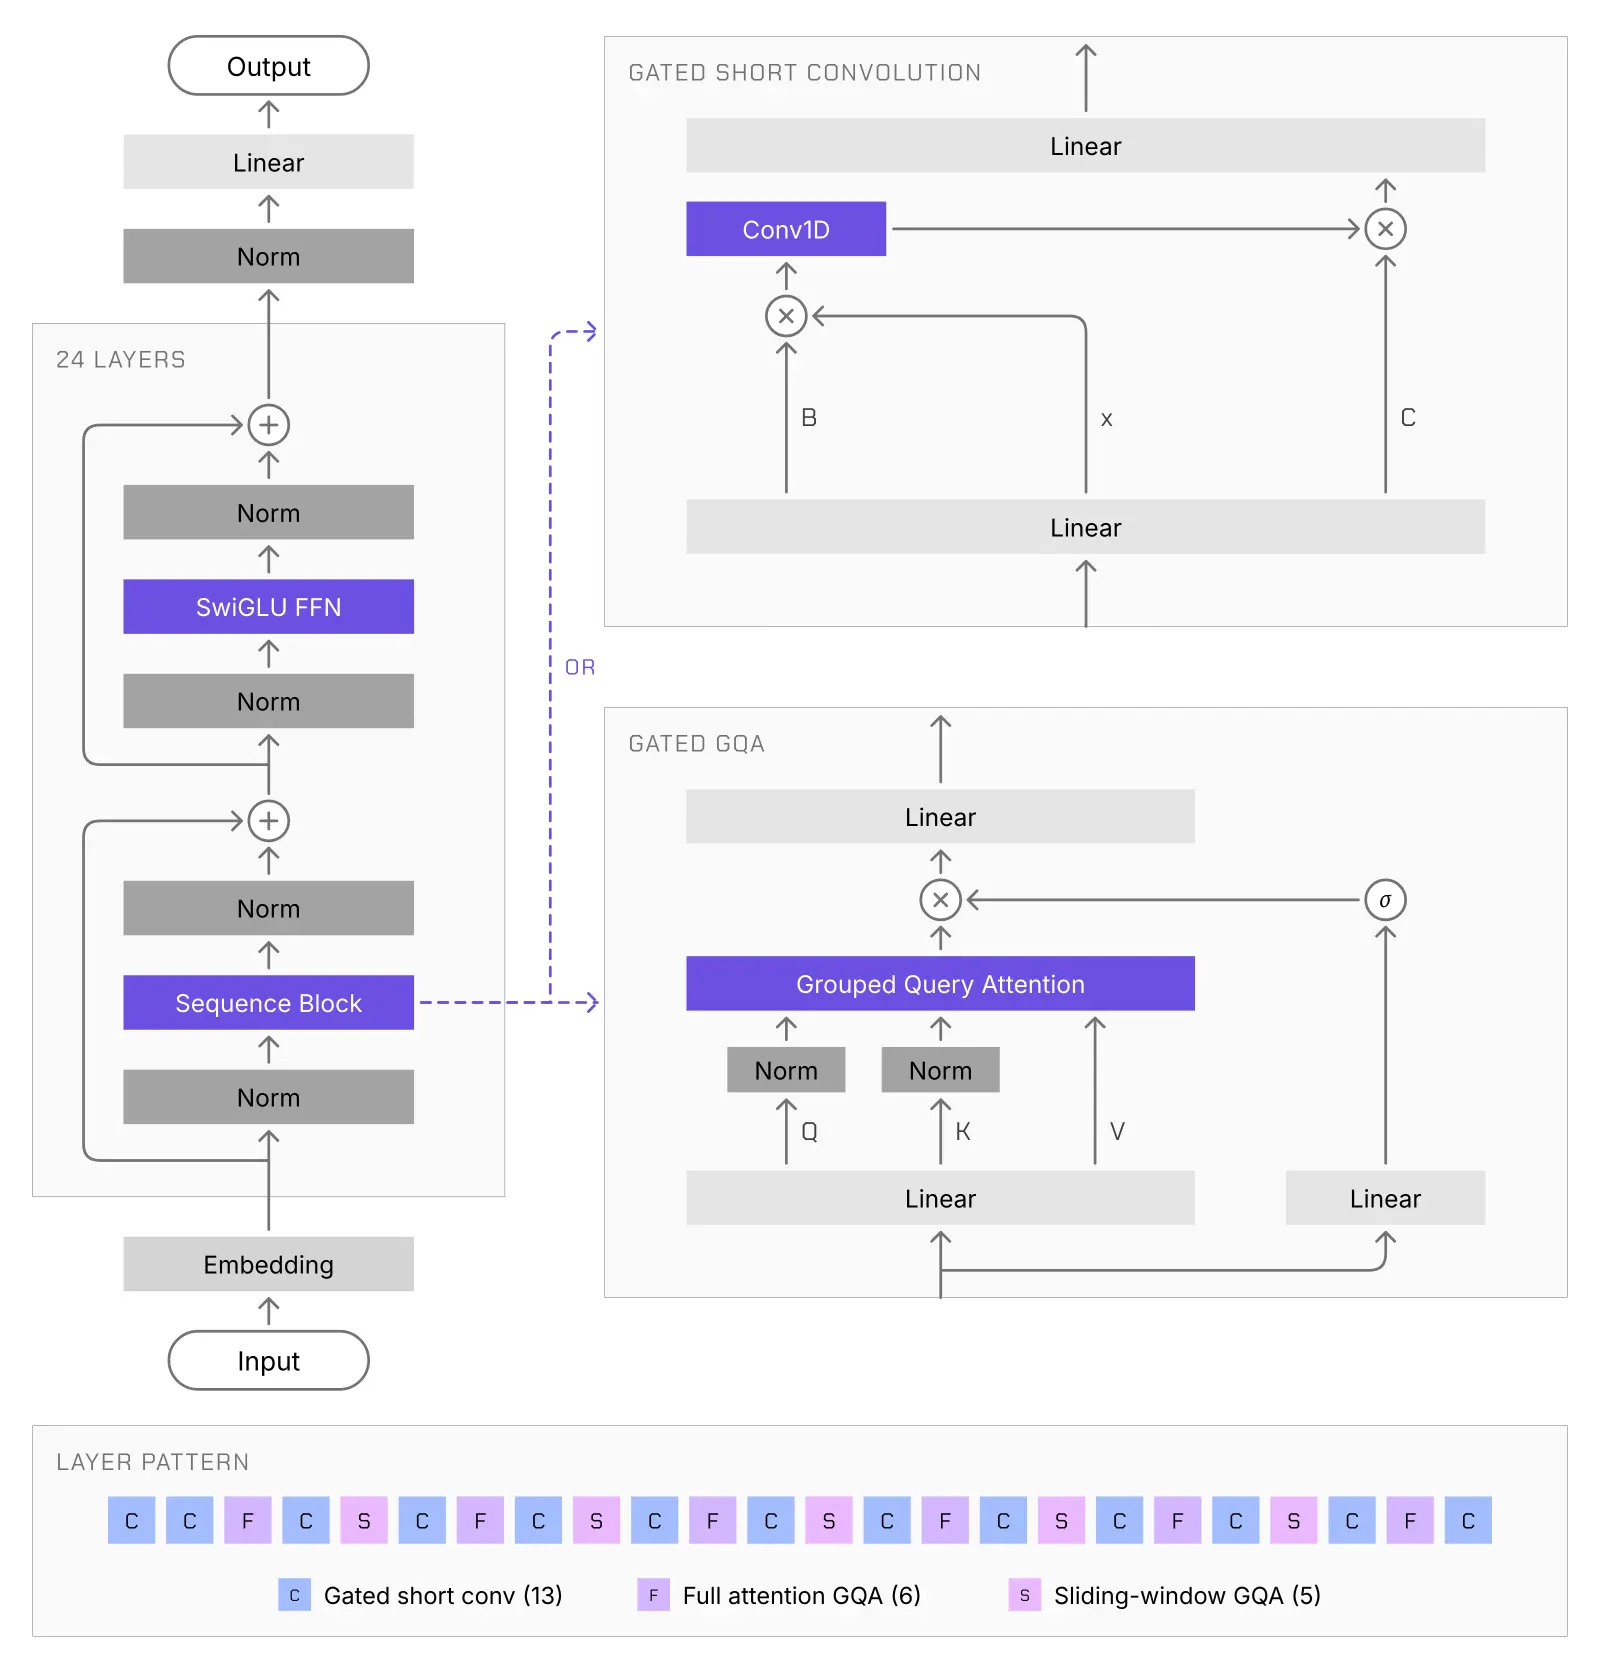
Een deel van de winst komt uit een nieuwe opbouw van het model, die Liquid heeft afgestemd op 14 combinaties van apparaten, van een Raspberry Pi 5 en telefoons tot laptops en de NPU-chip van Qualcomm. Bij lange invoer zou LFM3 daardoor zo'n 25 procent sneller zijn.
Waarom kleine modellen ertoe doen
Een model dat lokaal draait, stuurt je gegevens niet naar een cloud. Voor Europese bedrijven die met privacygevoelige documenten of gesprekken werken, is dat een groot voordeel. Liquid benadrukt ook dat elk model op één enkele GPU bij te trainen is, zodat een bedrijf er een specialist voor eigen vakjargon van kan maken.
Liquid bouwt al langer aan die niche. Eerder deze maand verscheen LFM2.5-24B-A2B voor agents op je laptop en lanceerde het bedrijf RIPL, een engine voor antwoorden binnen 50 milliseconden. Ook browsermaker Opera zet in op lokale AI, met een nieuwe standaard om modellen in de browser te draaien.