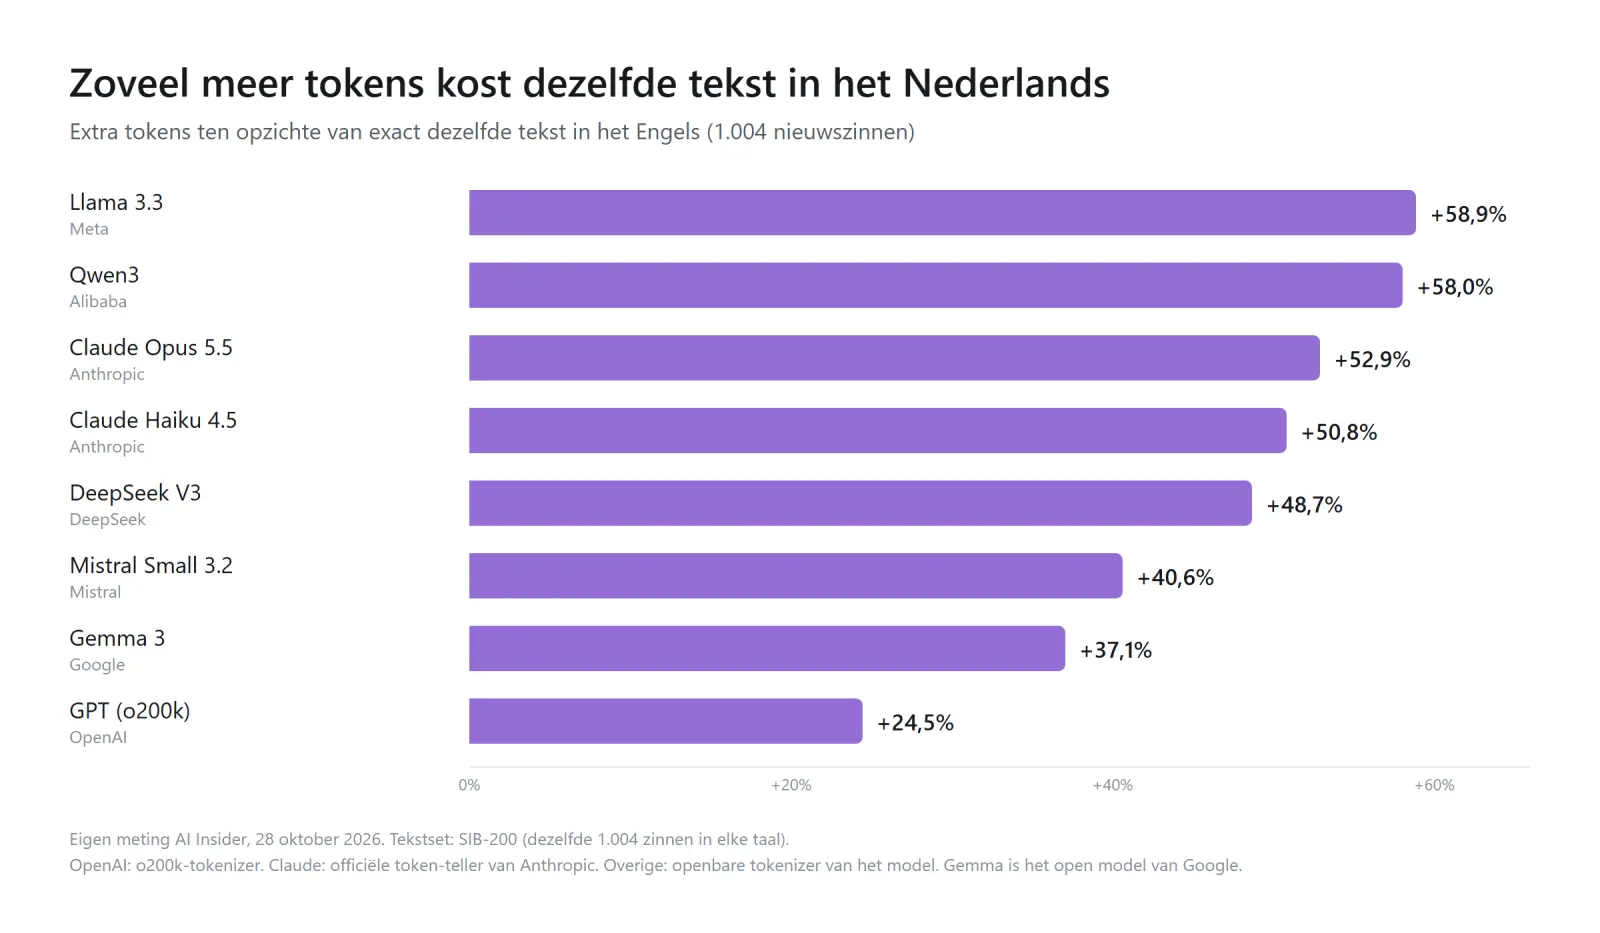
Stel je een AI-model een vraag in het Nederlands, dan gebruik je meer tokens dan wanneer je precies hetzelfde in het Engels vraagt. Dat blijkt uit een meting van AI Insider. Bij de modellen van OpenAI is het verschil het kleinst, bij Llama van Meta en Qwen van Alibaba het grootst. Wie AI via een API betaalt, ziet dat terug op de factuur. Met een abonnement raak je je limieten eerder kwijt.
Waarom Nederlands duurder uitvalt
Taalmodellen knippen tekst op in tokens: stukjes van een paar letters, een heel woord of een leesteken. Omdat de trainingsdata grotendeels Engels zijn, staan veel Engelse woorden als één token in het 'woordenboek' van een model. Nederlandse woorden, en zeker onze lange samenstellingen, worden vaker in meerdere stukken gehakt. Internationale onderzoekers noemen dat al langer de tokenizer tax: een verborgen toeslag voor iedereen die geen Engels spreekt. Een cijfer voor het Nederlands ontbrak tot nu toe.
De meting
AI Insider liet 1.004 korte nieuwszinnen uit de openbare vertaalset SIB-200 tellen door de tokenizers van acht modellen. Dezelfde zinnen in het Nederlands vroegen om zoveel extra tokens:
- OpenAI (GPT-modellen): 24,5 procent meer
- Gemma 3 (Google): 37,1 procent meer. Gemini zelf kon niet worden gemeten.
- Mistral Small 3.2: 40,6 procent meer
- DeepSeek V3: 48,7 procent meer
- Claude (Anthropic): 50,8 procent bij Haiku 4.5, 52,9 procent bij Opus 5.5
- Qwen3 en Llama 3.3: 58,0 en 58,9 procent meer
Duits en Frans zitten in dezelfde orde van grootte; bij Claude is Duits zelfs ruim 70 procent duurder dan Engels. Een opvallende bijvangst: Claude Opus 5.5 heeft ook voor de Engelse tekst veel meer tokens nodig dan Haiku 4.5. Een lage prijs per token zegt dus weinig zolang je niet weet hoeveel tokens een model voor jouw tekst gebruikt.
Wat het kost in de praktijk
Het rekenvoorbeeld van AI Insider: een bedrijf dat via Claude voor 1.000 euro per maand Engelse tekst verwerkt, zou voor dezelfde tekst in het Nederlands ongeveer 1.500 euro betalen. Bij OpenAI wordt dat zo'n 1.250 euro. Ook het contextvenster loopt sneller vol: in een model dat 200.000 tokens tegelijk leest, past in het Nederlands ongeveer een derde minder tekst.
Voor wie gewoon ChatGPT of Claude gebruikt met een abonnement, is er weinig reden om over te stappen op Engels. Het speelt vooral bij grootschalig gebruik, zoals klantenservice, vertalen of het verwerken van stapels documenten. Daar helpen een paar eenvoudige maatregelen: vaste instructies in het Engels schrijven met de opdracht om in het Nederlands te antwoorden, alleen de relevante delen van documenten meesturen en gebruikmaken van caching voor tekst die steeds terugkomt.
Goedkoper is niet hetzelfde als beter
Hoe zuinig een model met Nederlandse tekst omgaat, zegt niets over hoe goed het Nederlands begrijpt. Daarvoor kijkt AI Insider naar de Europese benchmark EuroEval, waarin de topmodellen dicht bij elkaar liggen en de verschillen vooral zitten in kennis over Nederland zelf. Een eigen Nederlands model, GPT-NL van TNO, NFI en SURF, is nog niet breed beschikbaar. Eerder zagen we dat ook bij spraakmodellen het Nederlands vaak achteraan aansluit: IBM liet onze taal zelfs helemaal weg uit Granite Speech 5.0.
Let wel: de meting gaat over korte nieuwszinnen. Bij juridische teksten of programmeercode kunnen de verhoudingen anders uitvallen.